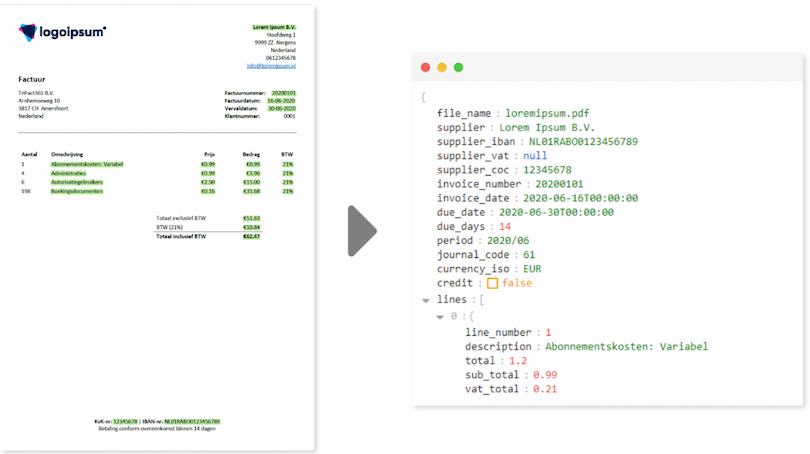
L’OCR facture fournisseur consiste à lire automatiquement vos factures et reçus par reconnaissance optique de caractères, afin que personne n’ait à ressaisir les données. L’OCR fournit le texte ; une seconde couche détermine ce que ce texte signifie. Dans cet article, vous verrez ce qu’est l’OCR, comment il fonctionne, comment se déroule le processus pour les factures, où il échoue, et pourquoi envoyer une facture directement à un modèle d’IA paraît séduisant mais se comporte autrement dans une comptabilité.
Le malentendu qui explique presque tout : on attend de l’OCR qu’il comprenne la facture. Ce n’est pas le cas. L’OCR lit des caractères et restitue du texte, rien de plus. Que 1 210 soit le total et non le sous-total, que la partie en haut à gauche soit le fournisseur et non le destinataire, et que ces charges relèvent d’un compte général précis : ce sont trois interprétations, et elles viennent d’ailleurs. Gardez cette distinction en tête et le reste de cet article coule de source.
Vous cherchez quelque chose de précis ? Pour le processus, allez à scanner des factures avec l’OCR. Pour les limites, voyez où la reconnaissance OCR échoue. Si vous vous demandez pourquoi ne pas confier la facture à une IA, passez à cette question. Et pour le côté produit, consultez la reconnaissance de factures.
Sommaire
- Qu’est-ce que l’OCR ?
- Comment fonctionne un logiciel OCR ?
- Où la reconnaissance OCR échoue-t-elle ?
- Comment fonctionne l’OCR dans le traitement des factures ?
- Scanner des factures avec l’OCR : le processus
- Qu’apporte l’OCR facture fournisseur ?
- Logiciel OCR facture : que vérifier ?
- OCR et comptabilité : qu’est-ce qui change ?
- Que devient une facture OCR après la lecture ?
- Peut-on envoyer la facture directement à une IA ?
- Pourquoi TriFact365 utilise deux couches
- Trois idées reçues tenaces
- Questions fréquentes sur l’OCR facture fournisseur
- Pour conclure
Qu’est-ce que l’OCR ?
OCR est l’abréviation d’Optical Character Recognition, soit la reconnaissance optique de caractères. Il s’agit d’un logiciel qui reconnaît les caractères, c’est-à-dire les lettres, les chiffres et la ponctuation, dans une image, et les convertit en texte numérique. Un scan, une photo ou un PDF devient ainsi un fichier dans lequel vous pouvez rechercher et qu’un autre logiciel peut exploiter. La technique existe depuis des décennies et constitue aujourd’hui le socle de la reconnaissance de factures.
Ce que l’OCR n’est pas : de la compréhension. La sortie est du texte brut avec des coordonnées, pas une proposition d’écriture. Cette distinction revient tout au long de l’article, car elle explique pourquoi une seconde couche est toujours nécessaire au-dessus.
Comment fonctionne un logiciel OCR ?
Sous le capot, l’OCR se déroule en quatre étapes. Une explication technique détaillée est disponible sur Wikipédia.
1. Prétraitement
L’image est redressée, le bruit est supprimé et le contraste est poussé vers le noir et blanc. Un scan de travers ou une ombre sur le reçu sont ici largement corrigés. Cette étape décide souvent de la réussite du reste.
2. Segmentation
Le logiciel découpe la page en blocs, lignes, mots et caractères isolés. Sur une facture comportant des tableaux sans filets, c’est la partie la plus délicate : où s’arrête une colonne et où commence la suivante ?
3. Reconnaissance des caractères
Chaque caractère est classé, aujourd’hui par des réseaux de neurones plutôt que par comparaison de motifs fixes. Le logiciel attribue un indice de confiance par caractère, et cet indice compte plus tard : il rend visible l’endroit où la reconnaissance a hésité.
4. Post-traitement
Des dictionnaires et des règles de contrôle corrigent les confusions classiques : un 8 qui ressemblait à un B, un 0 à un O, un 1 à un l. Pour les montants, cela aide à reconnaître un nombre à deux décimales comme une somme. Le résultat est du texte avec des positions et des indices de confiance.
Où la reconnaissance OCR échoue-t-elle ?
Dans le traitement des factures, la reconnaissance OCR a une seule mission : extraire les données du document pour que personne n’ait à les ressaisir. Mieux cela fonctionne, moins il reste de travail manuel, et il vaut donc la peine de savoir où la reconnaissance bute. En bref : le papier représente le risque le plus élevé, un PDF numérique un risque bien moindre, et avec une facture électronique structurée le risque de reconnaissance disparaît. Ce qui subsiste dans les trois cas, c’est le risque de la couche suivante. Voici les faiblesses connues :
| Là où cela coince | Pourquoi |
| Tickets de caisse effacés | Le papier thermique perd son contraste, et sans contraste pas de caractères |
| Écriture manuscrite | La variation des formes dépasse les capacités de la reconnaissance classique |
| Tableaux sans filets | La segmentation ignore où se termine une colonne |
| Tampons et paraphes sur le texte | Les pixels superposés rendent les caractères illisibles |
| Attribuer du sens | L’OCR livre du texte, pas une réponse à la question de savoir quel nombre est le total |
Les quatre premières lignes naissent toutes de l’image, et il y a là une gradation nette. Le papier, un scan ou une photo portent le risque complet, car tout dépend du contraste et de la netteté. Un PDF produit directement par un logiciel comptable ou de facturation contient déjà les caractères sous forme de texte : il y a peu à reconnaître, donc peu qui puisse échouer. Attention à la nuance, car un PDF scanné n’est pas du texte mais une image et retombe dans la première catégorie. Avec une facture électronique structurée comme l’UBL, le risque de reconnaissance disparaît entièrement, puisque les champs arrivent nommés.
Reste la dernière ligne, et elle vaut dans les trois cas. Même une facture UBL ne dit pas à quel compte général les charges appartiennent ni quel code de TVA s’applique. La lecture peut donc être supprimée en changeant le mode de réception ; l’interprétation, non. Cela demande une seconde couche, et cet article y revient plus bas.
Comment fonctionne l’OCR dans le traitement des factures ?
Au sein du processus plus large du traitement des factures, l’OCR remplit un seul rôle : supprimer l’étape de saisie. Sans lui, quelqu’un doit ressaisir chaque facture avant que quoi que ce soit puisse se produire avec les données. Avec l’OCR, celles-ci sont disponibles immédiatement, ce qui permet à la chaîne de se dérouler : rapprochement avec une commande, circuit de validation, puis paiement.
L’OCR facture fournisseur n’est donc pas un objectif dans le traitement des factures, mais une condition. Le gain ne réside pas dans la lecture elle-même, mais dans tout ce qui devient possible ensuite sans attente. Une facture reçue lundi peut être en attente de validation dès lundi, au lieu d’attendre la session de saisie hebdomadaire.
Scanner des factures avec l’OCR : le processus
Pour les documents professionnels, le chemin de la réception à l’écriture comporte six étapes. Observez où passe la frontière entre lire et comprendre :
| Étape | Ce qui se passe | Couche |
| 1. Réception | Scan, photo depuis l’application, pièce jointe ou fichier UBL | Entrée |
| 2. Lecture | Les caractères sont reconnus, avec position et indice de confiance | OCR |
| 3. Reconnaissance des champs | Quel nombre est le total, qui est le fournisseur, quel est le numéro de facture | Interprétation |
| 4. Imputation | Compte général et code de TVA proposés à partir de l’historique | Interprétation |
| 5. Contrôle | Vérifier et compléter, par exemple avec un centre de coûts | Humain |
| 6. Transfert | L’écriture validée part vers le logiciel comptable | Connexion |
L’étape deux, c’est l’OCR, et rien de plus. Tout ce qui suit à partir de l’étape trois relève d’une autre technique, et c’est précisément là que les éditeurs laissent la frontière s’estomper dans leur communication. Pour la numérisation elle-même, voyez le logiciel de numérisation de factures.
Qu’apporte l’OCR facture fournisseur ?
- Plus de ressaisie. Montants, dates et numéros de facture proviennent du document lui-même.
- Tous les formats de réception. PDF, JPG, PNG, TIFF et papier via un scan ou une photo prise dans l’application.
- Un archivage consultable. Un reçu scanné se retrouve par fournisseur et par montant plutôt que par nom de fichier.
- Moins d’erreurs de frappe. Les chiffres intervertis dans un montant ne se produisent presque plus.
- Une origine par valeur. Comme l’OCR fournit les positions, vous pouvez montrer où sur le document un montant a été lu.
- Valable pour tous les documents. Des factures d’achat et des reçus jusqu’aux bons de livraison et notes de frais.
Logiciel OCR facture : que vérifier ?
- Produit-il une proposition d’écriture ou seulement du texte ? Un logiciel purement OCR vous donne un PDF consultable. Pour une comptabilité, il faut la reconnaissance des champs.
- Reconnaît-il au niveau de la ligne ? Les données d’en-tête suffisent pour un reçu, pas pour une facture à ventiler sur des centres de coûts.
- Apprend-il par fournisseur ? Sans apprentissage, vous corrigez la même chose sur chaque facture de la même partie.
- Montre-t-il d’où vient une valeur ? Lors d’un contrôle, vous voulez pouvoir désigner la partie du document qui a produit un montant.
- Se connecte-t-il à votre logiciel comptable ? Sans connexion, vous déplacez simplement la ressaisie vers un autre écran.
- Où vos documents sont-ils traités ? Les factures contiennent des données personnelles : interrogez l’éditeur sur le traitement et les durées de conservation.
OCR et comptabilité : qu’est-ce qui change ?
Avec l’OCR facture fournisseur, le travail de celui qui tient la comptabilité passe de la saisie au contrôle. Cela semble un changement mineur, mais cela redessine la journée : au lieu de deux heures de ressaisie d’affilée, vous examinez une série de propositions dont la plupart sont correctes. L’attention se déplace vers les exceptions.
Il y a aussi un revers. Contrôler demande une autre forme de concentration que saisir. Celui qui valide cent propositions correctes d’affilée sera moins vigilant sur la cent unième. Un bon logiciel n’envoie donc à un humain que les documents incertains, et cela n’est possible que si des indices de confiance existent. D’où ils viennent, et pourquoi cela ne va pas de soi, c’est l’objet du reste de cet article.
Que devient une facture OCR après la lecture ?
Tout ce qui précède concernait la première couche. Cette seconde couche, celle qui transforme une facture OCR en écriture, existe depuis aussi longtemps que l’OCR lui-même, mais elle a changé trois fois de nature. C’est précisément de là que vient la confusion sur l’endroit où l’OCR s’arrête.
- Modèles et règles de position. L’approche la plus ancienne : pour chaque fournisseur, on consignait où figuraient sur la page le numéro de facture et le montant total. Cela fonctionnait précisément tant que la mise en page ne changeait pas. Si un logo se déplaçait ou si le fournisseur changeait de papier à en-tête, le modèle cassait et quelqu’un devait le reconfigurer. Avec des centaines de fournisseurs, cette maintenance devenait un métier à part entière.
- Apprentissage automatique (une IA qui apprend d’exemples). Ensuite, les systèmes ont appris seuls, à partir d’exemples et de corrections, où se trouvent les champs, sans modèle par fournisseur. Le grand avantage : une facture d’une partie inconnue pouvait être renseignée correctement d’emblée, parce que le modèle reconnaissait les motifs communs aux factures. Les corrections des utilisateurs sont devenues le carburant de son amélioration.
- Modèles de langage (une IA qui comprend la langue). L’étape actuelle. Un modèle de langage lit le texte extrait dans son contexte et comprend que « Total TTC » se rapporte au montant voisin, même s’il n’a jamais vu cette formulation exacte. Les libellés inhabituels, les autres langues et les autres devises entrent ainsi à portée sans devoir être définis à l’avance.
Observez maintenant ce qui est arrivé à l’OCR pendant la même période : fonctionnellement, presque rien. La technique interne s’est améliorée, passant de la comparaison de motifs fixes aux réseaux de neurones, mais ce que l’OCR livre reste ce qu’il livrait il y a trente ans : des caractères, avec une position et un indice de confiance. Le saut se situe entièrement dans la couche au-dessus.
De là vient le flou. Parce que la seconde couche est devenue si visiblement plus intelligente, on appelle désormais « IA » l’ensemble de la chaîne. Dans la pratique, l’IA assure l’interprétation et l’OCR assure toujours la lecture. Qui retient cette distinction voit aussitôt pourquoi la question ci-dessous relève de la conception et non du marketing.
Peut-on envoyer la facture directement à une IA ?
C’est devenu la question la plus fréquente sur le sujet, et la réponse est que techniquement, oui. Les modèles d’IA multimodaux acceptent une image et renvoient des données structurées. Vous pouvez téléverser une photo de facture et demander les montants sans configurer nulle part une étape d’OCR. La plupart de ceux qui essaient une fois sont impressionnés.
La question n’est pas de savoir si cela fonctionne, mais si vous pouvez vous appuyer dessus lorsque le résultat entre dans votre grand livre.
Y a-t-il de l’OCR sous un modèle d’IA ?
Bonne question, et la réponse dépend de la construction. Il existe deux variantes. Dans la première, une étape d’OCR classique tourne simplement en amont : le texte est extrait puis transmis au modèle de langage sous forme de texte. L’OCR n’est alors pas supprimé mais caché.
Dans la seconde variante, le modèle traite l’image directement, sans étape distincte de reconnaissance de caractères. Il n’y a alors aucun moment où des caractères isolés assortis d’un indice de confiance voient le jour. Le modèle accomplit en fait le même travail, mais en un seul mouvement et d’une autre manière : il prédit le texte le plus probable au lieu de classer des caractères.
Cette différence entre prédire et classer paraît académique, mais elle a une conséquence très concrète. Un système qui classe et qui hésite renvoie un indice faible. Un système qui prédit et qui hésite renvoie une réponse fluide et plausible. Un montant qui semble juste mais ne figure pas sur la facture devient alors indiscernable d’un montant qui y figure réellement.
Le compromis : une couche ou deux
| Un modèle d’IA seul | OCR plus un modèle entraîné | |
| Mises en page inhabituelles | Solide, utilise contexte et position à la fois | Solide, à condition d’être entraîné sur des factures |
| Origine d’une valeur | Non démontrable | Démontrable sur le document |
| Rendre le doute visible | À peine | Un indice de confiance par champ |
| Reproductibilité | Peut varier d’une fois à l’autre | Même document, même résultat |
| Valeurs inventées | Possibles et difficiles à repérer | Très improbables, le texte vient du scan |
| Coût au volume | Plus élevé par document | Plus faible, l’OCR est bon marché |
| Mise en place | Peu de configuration | Davantage de configuration |
Pour une question ponctuelle sur un seul document, la voie directe l’emporte. Pour des milliers de factures par mois qui atterrissent dans un grand livre et devront encore tenir lors d’un contrôle des années plus tard, l’origine, la répétabilité et le doute visible pèsent plus lourd que le confort à l’installation.
Pourquoi TriFact365 utilise deux couches
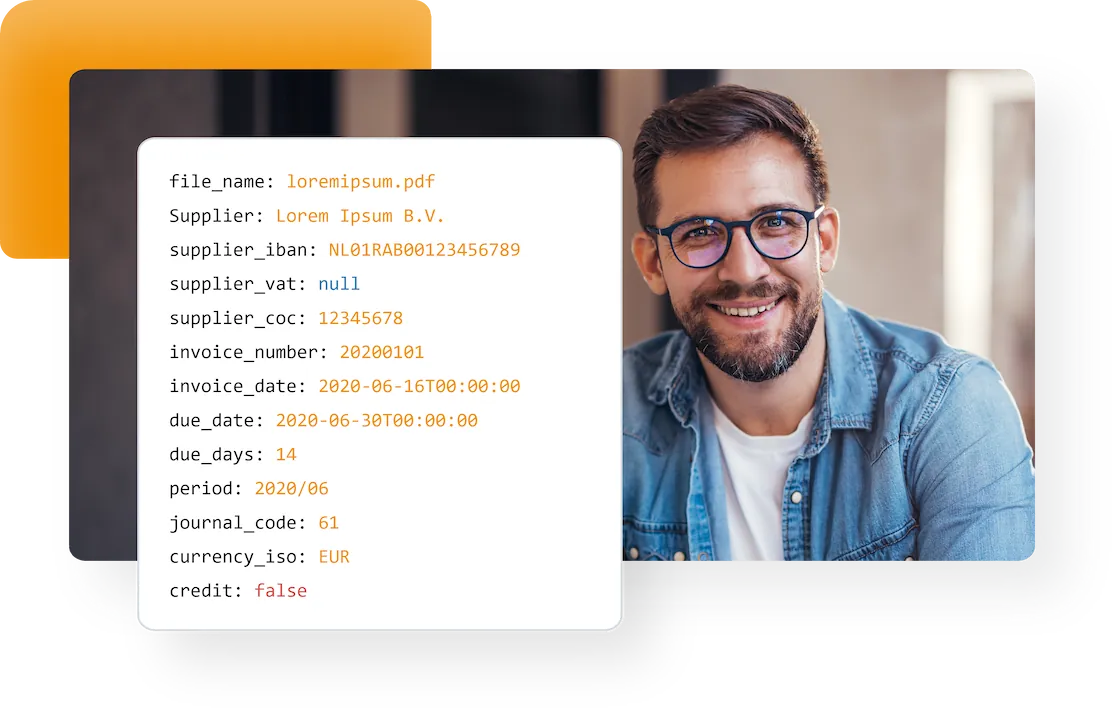
Chez TriFact365, l’OCR facture fournisseur repose sur deux couches, et cet ordre est un choix délibéré. La première livre le texte ferme, ancré à un endroit du document et assorti d’un indice de confiance. Les chiffres proviennent donc de la facture et non d’un modèle qui génère du texte. La seconde fait ce que l’OCR ne peut pas : déterminer quel nombre est le total, quelle partie est le fournisseur, et quels compte général et code de TVA s’appliquent, sur la base des écritures passées de ce fournisseur et jusqu’au niveau de la ligne.
Ce que le client en perçoit tient en quatre points :
- Moins d’erreurs silencieuses. Un montant erroné se remarque parce que la reconnaissance signale son doute, au lieu de paraître convaincante.
- Un contrôle plus ciblé. Les documents dont le logiciel est sûr demandent moins d’attention ; les cas douteux ressortent.
- Démontrable lors d’un contrôle. Le document d’origine figure à côté de la proposition et vous pouvez désigner l’endroit d’où vient une valeur.
- Meilleur par fournisseur. Une correction faite aujourd’hui se répercute sur la prochaine facture de la même partie.
Le résultat est une proposition d’écriture dans votre propre portail, avec le document à côté. Après votre contrôle et votre envoi, l’écriture arrive dans votre logiciel comptable.
Trois idées reçues tenaces
- « OCR et reconnaissance de factures, c’est pareil. » L’OCR est la première étape. La reconnaissance de factures, c’est l’OCR plus l’interprétation plus l’imputation. Les éditeurs qui ne livrent que de l’OCR vous vendent un PDF consultable.
- « Avec les factures électroniques, l’OCR ne sert plus. » Exact pour la lecture : une facture UBL livre déjà les données structurées. Mais le compte général et le code de TVA qui s’appliquent n’y figurent pas, donc la seconde couche reste nécessaire.
- « L’IA a rendu l’OCR obsolète. » Pour une question isolée sur un document, souvent oui. Dans une comptabilité où comptent l’origine, la répétabilité et la vérifiabilité, la combinaison est plus solide que l’un des deux seul.
Questions fréquentes sur l’OCR facture fournisseur
L’OCR facture fournisseur consiste à lire automatiquement les factures d’achat par reconnaissance optique de caractères. Une seconde couche détermine ensuite quel nombre est le total, qui est le fournisseur et quelle écriture s’applique.
OCR signifie Optical Character Recognition, soit la reconnaissance optique de caractères. C’est la technique qui reconnaît les caractères dans une image et les convertit en texte numérique avec positions et indices de confiance.
L’OCR lit le texte d’un document. La reconnaissance de factures va plus loin et rattache ce texte à des champs comme le fournisseur, le montant et la TVA, puis propose un compte général. L’OCR fait donc partie de la reconnaissance de factures, ce n’est pas la même chose.
Techniquement oui : les modèles multimodaux lisent une image directement. L’inconvénient est qu’un tel modèle prédit du texte au lieu de classer des caractères, si bien qu’un montant plausible mais faux ne se remarque pas et que l’origine n’est pas démontrable.
Cela dépend de la construction. Certaines solutions exécutent d’abord une étape d’OCR classique et transmettent le texte au modèle ; l’OCR est alors caché, pas supprimé. D’autres traitent l’image directement, sans reconnaissance de caractères distincte ni indices de confiance.
L’OCR supprime l’étape de saisie. Les données sont disponibles immédiatement, ce qui permet au rapprochement, à la validation et au paiement de se dérouler sans que personne ne ressaisisse la facture au préalable.
Des images et des scans comme PDF, JPG, PNG et TIFF, ainsi que des photos prises depuis une application mobile. Les fichiers UBL n’ont pas besoin d’OCR, car ils livrent déjà les données structurées.
Non. Numériser produit une image du document. L’OCR convertit cette image en texte consultable. La numérisation est la première étape, l’OCR la seconde.
Les tickets de caisse sont imprimés sur papier thermique, qui s’efface. Sans contraste entre le texte et le fond, il n’y a rien à reconnaître. Photographiez le ticket dès sa réception plutôt qu’à la clôture mensuelle.
Chez TriFact365, plus de 90 % des factures sont reconnues correctement d’emblée, grâce à la combinaison de l’OCR et d’une IA auto-apprenante. La reconnaissance s’affine en outre à chaque facture traitée du même fournisseur.
Pour conclure
L’OCR facture fournisseur tient à une seule distinction : lire n’est pas comprendre. L’OCR fournit les caractères, de façon fiable et démontrable ; un modèle entraîné en fait une écriture. La tentation de compresser les deux en une seule étape est forte, et pour une question ponctuelle cela fonctionne très bien. Dès qu’il s’agit de milliers de factures qui devront encore tenir des années plus tard, l’origine et la répétabilité ne sont pas un luxe.