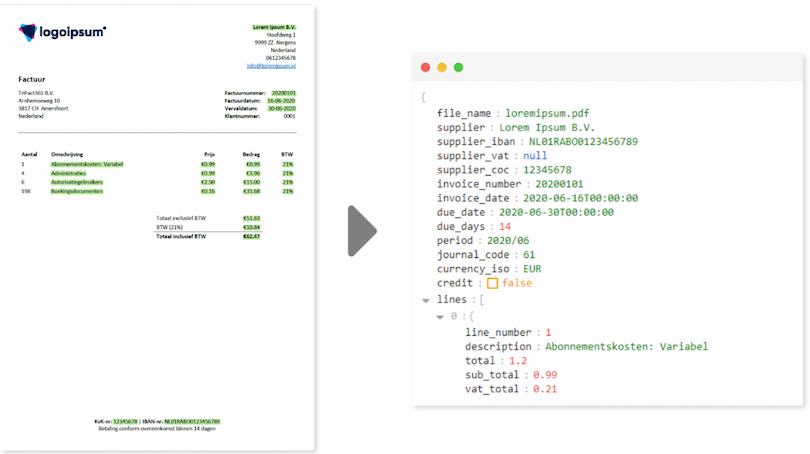
OCR Rechnungserkennung ist das automatische Auslesen von Rechnungen und Belegen mit optischer Zeichenerkennung, sodass niemand die Daten mehr abtippen muss. OCR liefert dabei den Text; eine zweite Schicht bestimmt, was dieser Text bedeutet. In diesem Artikel lesen Sie, was OCR ist, wie es funktioniert, wie der Prozess bei Rechnungen abläuft, wo er scheitert, und warum es verlockend klingt, eine Rechnung direkt an ein KI-Modell zu schicken, in der Buchhaltung aber anders ausgeht.
Der Irrtum, der fast alles erklärt: Man erwartet, dass OCR die Rechnung versteht. Das tut es nicht. OCR liest Zeichen und liefert Text, mehr nicht. Dass 1.210 der Gesamtbetrag ist und nicht die Zwischensumme, dass die Partei oben links der Lieferant ist und nicht der Empfänger, und dass diese Kosten auf ein bestimmtes Sachkonto gehören: das sind alles drei Interpretationen, und die kommen von woanders. Wer diese Trennung im Kopf behält, versteht den Rest dieses Artikels von selbst.
Suchen Sie etwas Bestimmtes? Wollen Sie den Prozess bei Rechnungen sehen, gehen Sie zu Rechnungen scannen mit OCR. Interessieren Sie die Grenzen, die stehen bei wo OCR-Erkennung scheitert. Fragen Sie sich, warum man die Rechnung nicht einfach einer KI gibt, dann springen Sie zu dieser Frage. Und für die Produktseite schauen Sie bei Rechnungserkennung mit KI.
Inhaltsverzeichnis
- Was ist OCR?
- Wie funktioniert OCR-Software?
- Wo stößt OCR-Erkennung an ihre Grenzen?
- Wie funktioniert OCR in der Rechnungsverarbeitung?
- Rechnungen scannen mit OCR: der Prozess
- Was bringt OCR Rechnungserkennung?
- OCR Software für Rechnungen: worauf achten?
- OCR und Buchhaltung: was ändert sich?
- Was passiert mit OCR Rechnungen nach dem Auslesen?
- Kann man die Rechnung nicht direkt an eine KI schicken?
- Warum TriFact365 zwei Schichten nutzt
- Drei hartnäckige Irrtümer
- Häufige Fragen zur OCR Rechnungserkennung
- Fazit
Was ist OCR?
OCR ist die Abkürzung für Optical Character Recognition, also optische Zeichenerkennung. Es handelt sich um Software, die Zeichen, also Buchstaben, Ziffern und Satzzeichen, in einem Bild erkennt und in digitalen Text umwandelt. So wird aus einem Scan, einem Foto oder einer PDF eine Datei, in der Sie suchen können und die andere Software weiterverarbeiten kann. Die Technik gibt es seit Jahrzehnten, und sie bildet inzwischen das Fundament unter der Rechnungserkennung mit KI.
Was OCR nicht ist: Verständnis. Die Ausgabe besteht aus reinem Text mit Koordinaten, nicht aus einem Buchungsvorschlag. Dieser Unterschied kehrt in diesem Artikel immer wieder, denn er erklärt, warum darüber stets eine zweite Schicht nötig ist.
Wie funktioniert OCR-Software?
Unter der Haube läuft OCR in vier Schritten ab. Eine ausführliche technische Erläuterung finden Sie auf Wikipedia.
1. Vorverarbeitung
Das Bild wird gerade gerückt, Rauschen wird entfernt und der Kontrast bis auf Schwarzweiß angehoben. Ein schiefer Scan oder ein Schatten über dem Beleg wird hier bereits weitgehend ausgeglichen. Dieser Schritt entscheidet oft darüber, ob der Rest gelingt.
2. Segmentierung
Die Software teilt die Seite in Blöcke, Zeilen, Wörter und einzelne Zeichen auf. Bei einer Rechnung mit Tabellen ohne Trennlinien ist das der schwierigste Teil: Wo endet die eine Spalte und wo beginnt die nächste?
3. Zeichenerkennung
Jedes Zeichen wird klassifiziert, heute mit neuronalen Netzen statt mit festem Mustervergleich. Die Software vergibt pro Zeichen einen Sicherheitswert, und genau dieser Wert wird später wichtig: Er macht sichtbar, wo die Erkennung gezweifelt hat.
4. Nachbearbeitung
Wörterbücher und Prüfregeln korrigieren die klassischen Verwechslungen: eine 8, die wie ein B aussah, eine 0, die wie ein O aussah, eine 1, die wie ein l aussah. Bei Beträgen hilft das, eine Zahl mit zwei Nachkommastellen als Betrag zu erkennen. Das Ergebnis ist Text mit Positionen und Sicherheitswerten.
Wo stößt OCR-Erkennung an ihre Grenzen?
OCR-Erkennung hat in der Rechnungsverarbeitung eine einzige Aufgabe: die Daten aus dem Dokument zu holen, damit niemand sie abtippen muss. Je besser das gelingt, desto weniger Handarbeit bleibt, und deshalb lohnt es sich zu wissen, wo die Erkennung scheitert. Kurz gesagt: Papier ist das größte Risiko, eine digitale PDF ein weit kleineres, und bei einem strukturierten E-Rechnungsformat entfällt das Erkennungsrisiko ganz. Was in allen drei Fällen bleibt, ist das Risiko der Schicht danach. Das sind die bekannten Schwachstellen:
| Wo es schiefgeht | Warum |
| Verblasste Kassenbelege | Thermopapier verliert Kontrast, und ohne Kontrast keine Zeichen |
| Handschrift | Die Formvarianz ist für klassische Zeichenerkennung zu groß |
| Tabellen ohne Linien | Die Segmentierung weiß nicht, wo eine Spalte endet |
| Stempel und Paraphe über Text | Überlappende Pixel machen Zeichen unlesbar |
| Bedeutung zuweisen | OCR liefert Text, aber keine Antwort darauf, welche Zahl der Gesamtbetrag ist |
Die ersten vier Zeilen entstehen alle beim Bild, und darin liegt eine klare Abstufung. Papier, ein Scan oder ein Foto trägt das volle Risiko, denn alles hängt an Kontrast und Schärfe. Eine PDF, die direkt aus einem Buchhaltungs- oder Fakturierungsprogramm stammt, enthält die Zeichen bereits als Text: Da gibt es wenig zu erkennen und entsprechend wenig, das schiefgehen kann. Achten Sie auf den Unterschied, denn eine eingescannte PDF ist kein Text, sondern ein Bild, und fällt damit in die erste Kategorie. Bei einem strukturierten E-Rechnungsformat entfällt das Erkennungsrisiko vollständig, weil die Felder benannt enthalten sind.
Dann bleibt die letzte Zeile, und die gilt in allen drei Fällen. Auch eine strukturierte E-Rechnung sagt nicht, auf welches Sachkonto die Kosten gehören oder welcher Steuerschlüssel dazugehört. Das Erkennen lässt sich also durch eine andere Anlieferung wegnehmen; das Interpretieren nicht. Dafür ist eine zweite Schicht nötig, und die kommt weiter unten in diesem Artikel zur Sprache.
Wie funktioniert OCR in der Rechnungsverarbeitung?
Innerhalb des größeren Prozesses der digitalen Rechnungsverarbeitung erfüllt OCR eine einzige Rolle: den Erfassungsschritt zu beseitigen. Ohne OCR muss jemand jede Rechnung abtippen, bevor mit den Daten überhaupt etwas geschehen kann. Mit OCR stehen die Daten sofort bereit, wodurch der Rest der Kette durchlaufen kann: Abgleich mit einer Bestellung, ein Freigabeweg und schließlich die Zahlung.
Damit ist OCR Rechnungserkennung in der Rechnungsverarbeitung kein Ziel, sondern eine Voraussetzung. Der Gewinn liegt nicht im Auslesen selbst, sondern in allem, was danach ohne Wartezeit möglich wird. Eine Rechnung, die am Montag eingeht, kann am Montag zur Freigabe bereitstehen statt erst nach der wöchentlichen Erfassungsrunde.
Rechnungen scannen mit OCR: der Prozess
Bei geschäftlichen Dokumenten verläuft der Weg vom Eingang bis zur Buchung in sechs Schritten. Achten Sie darauf, wo die Trennung zwischen Lesen und Verstehen liegt:
| Schritt | Was geschieht | Schicht |
| 1. Anliefern | Scan, Foto aus der App, E-Mail-Anhang oder strukturierte Datei | Eingabe |
| 2. Auslesen | Zeichen werden erkannt, mit Position und Sicherheitswert | OCR |
| 3. Felderkennung | Welche Zahl ist der Gesamtbetrag, wer ist der Lieferant, wie lautet die Rechnungsnummer | Interpretation |
| 4. Kontierung | Sachkonto und Steuerschlüssel auf Basis der Historie vorschlagen | Interpretation |
| 5. Kontrolle | Beurteilen und ergänzen, etwa um eine Kostenstelle | Mensch |
| 6. Übertragung | Die freigegebene Buchung geht in die Buchhaltungssoftware | Schnittstelle |
Schritt zwei ist OCR, mehr nicht. Alles ab Schritt drei ist eine andere Technik, und genau dort lassen Anbieter in ihrer Werbung die Grenze verschwimmen. Mehr zum Scannen selbst lesen Sie unter Rechnungen digitalisieren.
Was bringt OCR Rechnungserkennung?
- Kein Abtippen mehr. Beträge, Daten und Rechnungsnummern stammen aus dem Dokument selbst.
- Jedes Anlieferformat. PDF, JPG, PNG, TIFF und Papier über einen Scan oder ein Foto aus der App.
- Durchsuchbares Archiv. Ein gescannter Beleg wird über Lieferant und Betrag auffindbar statt über den Dateinamen.
- Weniger Tippfehler. Vertauschte Ziffern in einem Betrag kommen kaum noch vor.
- Herkunft je Wert. Da OCR Positionen mitliefert, lässt sich zeigen, wo auf dem Dokument ein Betrag herkommt.
- Funktioniert für alle Belege. Von Eingangsrechnungen und Kassenbelegen bis zu Lieferscheinen und Spesenabrechnungen.
OCR Software für Rechnungen: worauf achten?
- Liefert sie einen Buchungsvorschlag oder nur Text? Reine OCR-Software gibt Ihnen eine durchsuchbare PDF. Für eine Buchhaltung brauchen Sie Felderkennung.
- Erkennt sie auf Positionsebene? Nur Kopfdaten reichen für einen Beleg, nicht für eine Rechnung, die Sie auf Kostenstellen verteilen wollen.
- Lernt sie je Lieferant? Ohne Lernfähigkeit korrigieren Sie bei jeder Rechnung derselben Partei dasselbe.
- Zeigt sie, woher ein Wert stammt? Bei einer Prüfung wollen Sie zeigen können, welcher Teil des Dokuments einen Betrag ergeben hat.
- Gibt es eine Schnittstelle zu Ihrer Buchhaltung? Ohne Anbindung verlagern Sie das Abtippen nur in ein anderes Fenster.
- Wo werden Ihre Dokumente verarbeitet? Rechnungen enthalten personenbezogene Daten, fragen Sie also nach Verarbeitung und Aufbewahrungsfristen.
OCR und Buchhaltung: was ändert sich?
Mit OCR Rechnungserkennung verschiebt sich die Arbeit derjenigen, die die Buchhaltung machen, vom Erfassen zum Kontrollieren. Das klingt nach einer kleinen Veränderung, betrifft aber den Tagesablauf: Statt zwei Stunden am Stück abzutippen, beurteilen Sie eine Reihe von Vorschlägen, von denen die meisten stimmen. Die Aufmerksamkeit geht dann zu den Ausnahmen.
Es gibt auch eine Kehrseite. Beurteilen verlangt eine andere Art von Konzentration als Erfassen. Wer hundert korrekte Vorschläge hintereinander freigibt, wird beim hundertersten weniger aufmerksam. Gute Software schickt deshalb nur die unsicheren Dokumente zu einem Menschen, und das geht nur, wenn Sicherheitswerte vorliegen. Woher die kommen, und warum das nicht selbstverständlich ist, davon handelt der Rest dieses Artikels.
Was passiert mit OCR Rechnungen nach dem Auslesen?
Alles bisher ging über die erste Schicht. Jene zweite Schicht, die aus OCR Rechnungen eine Buchung macht, existiert genauso lange wie OCR selbst, nur hat sie dreimal ihren Charakter geändert. Genau dort liegt die Verwirrung darüber, wo OCR aufhört.
- Vorlagen und Positionsregeln. Der älteste Ansatz: Je Lieferant wurde festgelegt, wo auf der Seite Rechnungsnummer und Gesamtbetrag stehen. Das funktionierte genau, solange das Layout gleich blieb. Wanderte ein Logo oder bekam der Lieferant neues Briefpapier, brach die Vorlage und jemand musste sie neu einstellen. Bei hunderten Lieferanten wurde diese Pflege zu einem eigenen Job.
- Machine Learning (KI, die aus Beispielen lernt). Danach lernten Systeme aus Beispielen und Korrekturen selbst, wo Felder stehen, ohne Vorlage je Lieferant. Der große Vorteil: Eine Rechnung einer unbekannten Partei ließ sich sofort brauchbar ausfüllen, weil das Modell Muster erkannte, die Rechnungen gemeinsam haben. Korrekturen der Nutzer wurden zum Treibstoff, mit dem es besser wurde.
- Sprachmodelle (KI, die Sprache versteht). Der aktuelle Schritt. Ein Sprachmodell liest den ausgelesenen Text im Zusammenhang und versteht, dass „Gesamtbetrag inkl. MwSt.“ zu der Zahl daneben gehört, auch wenn es genau diese Formulierung nie zuvor gesehen hat. Ebenso fallen abweichende Bezeichnungen, andere Sprachen und Währungen in Reichweite, ohne dass Sie sie vorab definieren müssen.
Achten Sie nun darauf, was im selben Zeitraum mit OCR geschah: funktional so gut wie nichts. Die Technik darin wurde besser, von festem Mustervergleich hin zu neuronalen Netzen, aber was OCR liefert, ist noch immer dasselbe wie vor dreißig Jahren: Zeichen, mit einer Position und einem Sicherheitswert. Der Sprung liegt vollständig in der Schicht darüber.
Daher rührt die Unschärfe. Weil die zweite Schicht so sichtbar klüger wurde, nennt man die ganze Kette inzwischen „KI“. In der Praxis übernimmt die KI die Interpretation und OCR nach wie vor das Lesen. Wer diesen Unterschied festhält, sieht auch sofort, warum die Frage weiter unten keine Marketingfrage ist, sondern eine Konstruktionsfrage.
Kann man die Rechnung nicht direkt an eine KI schicken?
Das ist inzwischen die häufigste Frage zu diesem Thema, und die Antwort lautet: technisch geht das. Moderne multimodale KI-Modelle nehmen ein Bild entgegen und geben strukturierte Daten zurück. Sie können ein Foto einer Rechnung hochladen und nach den Beträgen fragen, ohne irgendwo einen OCR-Schritt einzurichten. Wer das einmal ausprobiert, ist meist beeindruckt.
Die Frage ist nicht, ob es geht, sondern ob Sie darauf bauen können, wenn das Ergebnis in Ihr Hauptbuch wandert.
Steckt unter einem KI-Modell auch OCR?
Gute Frage, und die Antwort hängt von der Bauweise ab. Es gibt zwei Varianten. In der ersten läuft schlicht ein klassischer OCR-Schritt vorweg: Der Text wird ausgelesen und als Text an das Sprachmodell gegeben. Dann ist OCR nicht übersprungen, sondern versteckt.
In der zweiten Variante verarbeitet das Modell das Bild unmittelbar, ohne separaten Zeichenerkennungsschritt. Dann gibt es keinen Moment, in dem einzelne Zeichen mit einem Sicherheitswert entstehen. Das Modell leistet faktisch dieselbe Arbeit, aber als Teil einer einzigen Bewegung und auf andere Weise: Es sagt den wahrscheinlichsten Text voraus, statt Zeichen zu klassifizieren.
Dieser Unterschied zwischen Vorhersagen und Klassifizieren klingt akademisch, hat aber eine sehr praktische Folge. Ein klassifizierendes System, das zweifelt, gibt einen niedrigen Wert aus. Ein vorhersagendes System, das zweifelt, gibt eine flüssige und plausible Antwort aus. Ein Betrag, der gut aussieht, aber nicht auf der Rechnung steht, ist dann nicht von einem zu unterscheiden, der dort tatsächlich steht.
Die Abwägung: eine Schicht oder zwei
| Nur ein KI-Modell | OCR plus trainiertes Modell | |
| Abweichende Layouts | Stark, nutzt Kontext und Position zugleich | Stark, sofern auf Rechnungen trainiert |
| Herkunft eines Wertes | Nicht nachweisbar | Auf dem Dokument nachweisbar |
| Zweifel sichtbar machen | Kaum | Sicherheitswert je Feld |
| Reproduzierbarkeit | Kann je Durchlauf abweichen | Gleiches Dokument, gleiches Ergebnis |
| Erfundene Werte | Möglich und schwer erkennbar | Sehr unwahrscheinlich, der Text stammt aus dem Scan |
| Kosten bei Volumen | Höher je Dokument | Niedriger, OCR ist günstig |
| Einrichtung | Wenig Aufwand | Mehr Aufwand |
Für eine einmalige Frage zu einem Dokument gewinnt der direkte Weg. Für tausende Rechnungen im Monat, die in einem Hauptbuch landen und Jahre später bei einer Prüfung noch stimmen müssen, wiegen Herkunft, Reproduzierbarkeit und sichtbarer Zweifel schwerer als Bequemlichkeit bei der Einrichtung.
Warum TriFact365 zwei Schichten nutzt
Bei TriFact365 besteht die OCR Rechnungserkennung aus zwei Schichten, und diese Reihenfolge ist eine bewusste Entscheidung. Die erste Schicht liefert den harten Text, verankert an einer Stelle im Dokument und versehen mit einem Sicherheitswert. Die Zahlen stammen damit aus der Rechnung und nicht aus einem Modell, das Text erzeugt. Die zweite Schicht leistet, was OCR nicht kann: bestimmen, welche Zahl der Gesamtbetrag ist, welche Partei der Lieferant ist, und welches Sachkonto und welcher Steuerschlüssel dazugehören, auf Basis früherer Buchungen dieses Lieferanten und bis auf Positionsebene.
Was der Kunde davon merkt, lässt sich in vier Punkten zusammenfassen:
- Weniger stille Fehler. Ein falscher Betrag fällt auf, weil die Erkennung Zweifel meldet, statt überzeugend auszusehen.
- Gezielter kontrollieren. Dokumente, bei denen die Software sicher ist, brauchen weniger Aufmerksamkeit; die Zweifelsfälle stechen hervor.
- Nachweisbar bei einer Prüfung. Das Originaldokument steht neben dem Vorschlag, und Sie können zeigen, woher ein Wert stammt.
- Besser je Lieferant. Eine Korrektur von heute wirkt sich auf die nächste Rechnung derselben Partei aus.
Das Ergebnis ist ein Buchungsvorschlag im eigenen Portal, mit dem Dokument daneben. Nach Ihrer Kontrolle und Freigabe gelangt die Buchung in Ihre Buchhaltungssoftware, sofern eine Schnittstelle eingerichtet ist.
Drei hartnäckige Irrtümer
- „OCR und Rechnungserkennung sind dasselbe.“ OCR ist der erste Schritt. Rechnungserkennung ist OCR plus Interpretation plus Kontierung. Anbieter, die nur OCR liefern, verkaufen Ihnen eine durchsuchbare PDF.
- „Mit E-Rechnungen braucht man kein OCR mehr.“ Stimmt für das Auslesen: Eine strukturierte E-Rechnung liefert die Daten bereits fertig. Welches Sachkonto und welcher Steuerschlüssel dazugehören, steht dort aber nicht, also bleibt die zweite Schicht nötig.
- „KI hat OCR überflüssig gemacht.“ Bei einer einzelnen Frage zu einem Dokument oft ja. In einer Buchhaltung, in der Herkunft, Wiederholbarkeit und Prüfbarkeit zählen, ist die Kombination stärker als eines von beiden.
Häufige Fragen zur OCR Rechnungserkennung
OCR Rechnungserkennung ist das automatische Auslesen von Rechnungen mit optischer Zeichenerkennung. Danach bestimmt eine zweite Schicht, welche Zahl der Gesamtbetrag ist, wer der Lieferant ist und welche Buchung dazugehört.
OCR steht für Optical Character Recognition, also optische Zeichenerkennung. Die Technik erkennt Zeichen in einem Bild und wandelt sie in digitalen Text mit Positionen und Sicherheitswerten um.
OCR liest den Text eines Dokuments aus. Rechnungserkennung geht weiter und ordnet diesen Text Feldern wie Lieferant, Betrag und Steuer zu und schlägt ein Sachkonto vor. OCR ist also Teil der Rechnungserkennung, nicht dasselbe.
Technisch ja: Multimodale Modelle lesen ein Bild unmittelbar. Der Nachteil ist, dass ein solches Modell Text vorhersagt statt Zeichen zu klassifizieren, wodurch ein plausibler aber falscher Betrag nicht auffällt und die Herkunft nicht nachweisbar ist.
Das hängt von der Bauweise ab. Manche Lösungen führen zuerst einen klassischen OCR-Schritt aus und geben den Text an das Modell; dann ist OCR versteckt, nicht weg. Andere verarbeiten das Bild unmittelbar, ohne separate Zeichenerkennung mit Sicherheitswerten.
OCR beseitigt den Erfassungsschritt. Die Daten stehen sofort bereit, wodurch Abgleich, Freigabe und Zahlung durchlaufen können, ohne dass jemand die Rechnung zuerst abtippt.
Bilder und Scans wie PDF, JPG, PNG und TIFF, dazu Fotos aus einer mobilen App. Strukturierte E-Rechnungen brauchen kein OCR, weil sie die Daten bereits benannt liefern.
Nein. Scannen erzeugt ein Bild eines Dokuments. OCR wandelt dieses Bild in durchsuchbaren Text um. Scannen ist der erste Schritt, OCR der zweite.
Kassenbelege werden auf Thermopapier gedruckt und verblassen. Ohne Kontrast zwischen Text und Hintergrund gibt es nichts zu erkennen. Fotografieren Sie den Beleg deshalb beim Erhalt statt beim Monatsabschluss.
Bei TriFact365 werden über 90% der Rechnungen direkt korrekt erkannt, durch die Kombination aus OCR und selbstlernender KI. Die Erkennung wird zudem mit jeder verarbeiteten Rechnung desselben Lieferanten genauer.
Fazit
Bei der OCR Rechnungserkennung dreht sich alles um eine Trennung: Lesen ist etwas anderes als Verstehen. OCR liefert die Zeichen, zuverlässig und nachweisbar; ein trainiertes Modell macht daraus eine Buchung. Die Versuchung, beides in einen Schritt zu packen, ist groß, und für eine einzelne Frage funktioniert das gut. Sobald es um tausende Rechnungen geht, die Jahre später noch stimmen müssen, sind Herkunft und Wiederholbarkeit kein Luxus.