OCR factuurherkenning is het automatisch uitlezen van facturen en bonnen met optische tekenherkenning, zodat de gegevens niet meer hoeven te worden overgetypt. OCR levert daarbij de tekst; een tweede laag bepaalt wat die tekst betekent. In dit artikel lees je wat OCR is, hoe het werkt, hoe het proces bij facturen verloopt, waar het vastloopt, en waarom een factuur direct naar een AI-model sturen aantrekkelijk klinkt maar in de boekhouding anders uitpakt.
Het misverstand dat bijna alles verklaart: mensen verwachten dat OCR de factuur begrijpt. Dat doet het niet. OCR leest tekens en levert tekst, meer niet. Dat 1.210 het totaalbedrag is en niet het subtotaal, dat de partij linksboven de leverancier is en niet de ontvanger, en dat deze kosten op grootboekrekening 4300 horen: dat zijn alle drie interpretaties, en die komen ergens anders vandaan. Wie die scheiding vasthoudt, begrijpt de rest van dit artikel vanzelf.
Zoek je iets specifiekers? Wil je het proces bij facturen zien, ga naar facturen scannen met OCR. Zoek je de grenzen, die staan bij waar OCR vastloopt. Vraag je je af waarom je niet gewoon een AI de factuur voert, spring dan naar die vraag. En wil je de productkant, kijk dan bij factuurherkenning met AI.
Inhoudsopgave
- Wat is OCR?
- Hoe werkt OCR-software?
- Waar loopt OCR-herkenning vast?
- Hoe werkt OCR bij factuurverwerking?
- Facturen scannen met OCR: het proces
- Wat levert OCR factuurherkenning op?
- OCR software voor facturen: waar let je op?
- OCR en boekhouden: wat verandert er?
- Wat gebeurt er met OCR facturen na het uitlezen?
- Kun je de factuur niet direct naar een AI sturen?
- Waarom TriFact365 twee lagen gebruikt
- Drie hardnekkige misverstanden
- Veelgestelde vragen over OCR factuurherkenning
- Tot slot
Wat is OCR?
OCR is de afkorting van Optical Character Recognition, oftewel optische tekenherkenning. Het is software die tekens, dus letters, cijfers en leestekens, in een afbeelding herkent en omzet in digitale tekst. Zo maak je van een scan, foto of PDF een bestand waarin je kunt zoeken en dat andere software kan gebruiken. De techniek bestaat al decennia en vormt inmiddels het fundament onder factuurherkenning.
Wat OCR níét is: begrip. De uitvoer is platte tekst met coördinaten, geen boekingsvoorstel. Dat onderscheid keert in dit artikel steeds terug, want het verklaart waarom er altijd een tweede laag nodig is.
Hoe werkt OCR-software?
Onder de motorkap verloopt OCR-technologie in vier stappen. Een uitgebreide technische toelichting staat op Wikipedia.
1. Voorbewerking
De afbeelding wordt rechtgezet, ruis wordt verwijderd en het contrast wordt opgevoerd tot zwart-wit. Een scheve scan of een schaduw over de bon wordt hier al grotendeels gladgestreken. Deze stap bepaalt vaak of de rest lukt.
2. Segmentatie
De software verdeelt de pagina in blokken, regels, woorden en losse tekens. Bij een factuur met tabellen zonder randlijnen is dit het lastigste onderdeel: waar houdt de ene kolom op en begint de volgende?
3. Tekenherkenning
Elk teken wordt geclassificeerd, tegenwoordig met neurale netwerken in plaats van met vaste patroonvergelijking. De software geeft per teken een betrouwbaarheidsscore, en juist die score is later belangrijk: hij maakt zichtbaar waar de herkenning twijfelde.
4. Nabewerking
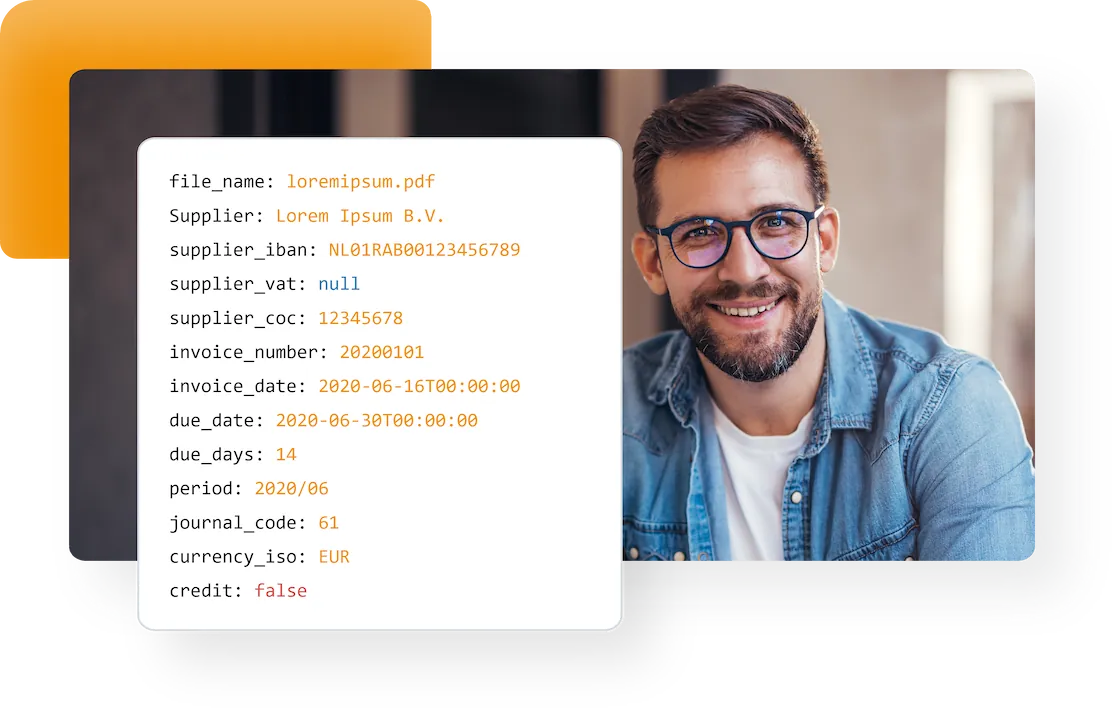
Woordenboeken en controleregels corrigeren de klassieke verwarringen: een 8 die een B leek, een 0 die een O leek, een 1 die een l leek. Bij bedragen helpt dat een getal met twee decimalen als bedrag te herkennen. Het resultaat is tekst met posities en betrouwbaarheidsscores.
Waar loopt OCR-herkenning vast?
OCR-herkenning heeft in factuurverwerking één taak: de gegevens van het document halen zodat niemand ze hoeft over te typen. Hoe beter dat lukt, hoe minder handwerk er overblijft, en daarom loont het te weten waar de herkenning spaak loopt. Kort gezegd: papier is het grootste risico, een digitale PDF een veel kleiner, en bij UBL bestaat het herkenningsrisico niet. Wat in alle drie de gevallen overblijft, is het risico van de laag erna. Dit zijn de bekende zwakke plekken:
| Waar het misgaat | Waarom |
| Vervaagde kassabonnen | Thermisch papier verliest contrast, en zonder contrast geen tekens |
| Handschrift | Vormvariatie is te groot voor klassieke tekenherkenning |
| Tabellen zonder lijnen | De segmentatie weet niet waar een kolom eindigt |
| Stempels en paraaf over tekst | Overlappende pixels maken tekens onherkenbaar |
| Betekenis toekennen | OCR levert tekst, geen antwoord op de vraag welk getal het totaal is |
De eerste vier rijen ontstaan allemaal bij beeld, en daarin zit een duidelijke trap. Papier, een scan of een foto draagt het volle risico, want alles hangt af van contrast en scherpte. Een PDF die rechtstreeks uit een boekhoud- of facturatiepakket komt, bevat de tekens al als tekst: daar valt weinig te herkennen en dus weinig fout te gaan. Let op het verschil, want een ingescande PDF is geen tekst maar een afbeelding en valt gewoon in de eerste categorie. Bij UBL, dat XML is, bestaat het herkenningsrisico helemaal niet meer: de velden staan er met naam en al in.
Dan de laatste rij, en die geldt in alle drie de gevallen. Ook een UBL-bestand vertelt niet op welke grootboekrekening de kosten horen of welke btw-code erbij past. Het herkennen kun je dus wegnemen door anders aan te leveren; het interpreteren niet. Daarvoor is een tweede laag nodig, en die komt verderop in dit artikel aan bod.
Hoe werkt OCR bij factuurverwerking?
Binnen het bredere proces van factuurverwerking vult OCR één rol: het verwijderen van de invoerstap. Zonder OCR moet iemand elke factuur overtypen voordat er iets met de gegevens kan gebeuren. Met OCR staat die data er meteen, waardoor de rest van de keten kan doorlopen: matching met een inkooporder, een goedkeuringsroute, en uiteindelijk betaling.
Dat maakt OCR factuurherkenning binnen factuurverwerking geen doel maar een voorwaarde. De winst zit niet in het uitlezen zelf, maar in alles wat daarna mogelijk wordt zonder wachttijd. Een factuur die maandag binnenkomt kan maandag ter goedkeuring staan in plaats van na de wekelijkse invoerronde.
Facturen scannen met OCR: het proces
Bij zakelijke documenten loopt het proces van binnenkomst tot boeking in zes stappen. Let op waar de scheiding tussen lezen en begrijpen zit:
| Stap | Wat er gebeurt | Laag |
| 1. Aanleveren | Scan, foto uit de app, e-mailbijlage of UBL-bestand | Invoer |
| 2. Uitlezen | Tekens worden herkend, met positie en betrouwbaarheid | OCR |
| 3. Veldherkenning | Welk getal is het totaal, wie is de leverancier, wat is het factuurnummer | Interpretatie |
| 4. Codering | Grootboekrekening en btw-code voorstellen op basis van historie | Interpretatie |
| 5. Controle | Beoordelen en aanvullen, bijvoorbeeld met een kostenplaats | Mens |
| 6. Verzending | De goedgekeurde boeking gaat naar het boekhoudpakket | Koppeling |
Stap twee is OCR, meer niet. Alles vanaf stap drie is een andere techniek, en dat is precies waar aanbieders in hun marketing de grens laten vervagen. Het scannen zelf lees je verder na bij scan en herken.
Wat levert OCR factuurherkenning op?
- Geen overtypwerk. Bedragen, datums en factuurnummers komen uit het document zelf.
- Elk aanleverformaat. PDF, JPG, PNG, TIFF en papier via een scan of een foto uit de app.
- Doorzoekbaar archief. Een gescande bon wordt terugvindbaar op leverancier en bedrag in plaats van op bestandsnaam.
- Minder tikfouten. Verwisselde cijfers in een bedrag komen nauwelijks meer voor.
- Herkomst per waarde. Doordat OCR posities meelevert, is aanwijsbaar wáár op het document een bedrag vandaan komt.
- Werkt op alle zakelijke documenten. Van inkoopfacturen en bonnen tot pakbonnen en declaraties.
OCR software voor facturen: waar let je op?
- Levert het een boekingsvoorstel of alleen tekst? Losse OCR-software geeft je een doorzoekbare PDF. Voor een administratie heb je veldherkenning nodig.
- Herkent het op regelniveau? Alleen kopgegevens is genoeg voor een bon, niet voor een factuur die je over kostenplaatsen wilt verdelen.
- Leert het per leverancier? Zonder leervermogen corrigeer je bij elke factuur van dezelfde partij hetzelfde.
- Toont het waar een waarde vandaan komt? Bij een controle wil je kunnen aanwijzen welk deel van het document een bedrag opleverde.
- Koppelt het met je boekhoudpakket? Zonder koppeling verplaats je het overtypen alleen naar een ander scherm.
- Waar worden je documenten verwerkt? Facturen bevatten persoonsgegevens, dus vraag naar verwerking en bewaartermijnen.
OCR en boekhouden: wat verandert er?
Met OCR factuurherkenning verschuift het werk van wie de boekhouding doet van invoeren naar controleren. Dat klinkt als een kleine verandering maar het raakt de dagindeling: in plaats van een blok van twee uur overtypen, beoordeel je een rij voorstellen waarvan het merendeel klopt. De aandacht gaat dan naar de uitzonderingen.
Er zit ook een keerzijde aan. Beoordelen vraagt een ander soort concentratie dan invoeren. Wie honderd correcte voorstellen achter elkaar goedkeurt, wordt minder scherp op de honderd en eerste. Goede software stuurt daarom alleen de onzekere documenten naar een mens, en dat kan alleen als er betrouwbaarheidsscores beschikbaar zijn. Waar die vandaan komen, en waarom dat niet vanzelfsprekend is, gaat de rest van dit artikel over.
Wat gebeurt er met OCR facturen na het uitlezen?
Alles hierboven ging over de eerste laag. Die tweede laag, die van OCR facturen een boeking maakt, bestaat al net zo lang als OCR zelf, alleen is hij drie keer van karakter veranderd. Juist daar zit de verwarring over waar OCR ophoudt.
- Sjablonen en positieregels. De oudste aanpak: per leverancier werd vastgelegd waar op de pagina het factuurnummer en het totaalbedrag stonden. Dat werkte nauwkeurig zolang de lay-out niet veranderde. Verhuisde een logo of kreeg de leverancier een nieuw briefpapier, dan brak het sjabloon en moest iemand het opnieuw instellen. Bij honderden leveranciers werd dat onderhoud een baan op zich.
- Machine learning (AI die leert van voorbeelden). Daarna leerden systemen uit voorbeelden en correcties zelf waar velden staan, zonder sjabloon per leverancier. Het grote voordeel: een factuur van een onbekende partij kon meteen redelijk worden ingevuld, omdat het model patronen herkende die facturen gemeen hebben. Correcties van gebruikers werden bovendien de brandstof waarop het beter werd.
- Taalmodellen (AI die taal begrijpt). De huidige stap. Een taalmodel leest de uitgelezen tekst in samenhang en begrijpt dat “Totaal incl. btw” hoort bij het bedrag ernaast, ook als het die precieze formulering nooit eerder heeft gezien. Ook afwijkende benamingen, andere talen en valuta’s vallen daarmee binnen bereik zonder dat je ze vooraf hoeft te definiëren.
Let nu op wat er in diezelfde periode met OCR gebeurde: in functie vrijwel niets. De techniek erin werd beter, van vaste patroonvergelijking naar neurale netwerken, maar wat OCR oplevert is nog steeds hetzelfde als dertig jaar geleden: tekens, met een positie en een betrouwbaarheidsscore. De sprong zit volledig in de laag erboven.
Daar komt de vervaging vandaan. Omdat de tweede laag zo zichtbaar slimmer werd, is men die hele keten “AI” gaan noemen. In de praktijk doet AI de interpretatie en doet OCR nog altijd het lezen. Wie dat onderscheid vasthoudt, ziet ook meteen waarom de vraag hieronder geen marketingvraag is maar een ontwerpvraag.
Kun je de factuur niet direct naar een AI sturen?
Dit is inmiddels de meestgestelde vraag over dit onderwerp, en het antwoord is: technisch kan dat. Moderne multimodale AI-modellen accepteren een afbeelding en geven gestructureerde gegevens terug. Je kunt een foto van een factuur uploaden en om de bedragen vragen, zonder ergens een OCR-stap te configureren. Wie dat een keer probeert, is meestal onder de indruk.
De vraag is niet of het kan, maar of je erop kunt bouwen als de uitkomst je grootboek in gaat.
Zit er onder een AI-model ook OCR?
Goede vraag, en het antwoord hangt af van de bouw. Er bestaan twee varianten. In de eerste draait er gewoon een klassieke OCR-stap vooraf: de tekst wordt uitgelezen en als tekst aan het taalmodel gevoerd. Dan is OCR niet overgeslagen maar verstopt.
In de tweede variant verwerkt het model de afbeelding rechtstreeks, zonder aparte tekenherkenningsstap. Er is dan geen moment waarop losse tekens met een betrouwbaarheidsscore ontstaan. Het model doet feitelijk hetzelfde werk, maar als onderdeel van één beweging en op een andere manier: het voorspelt de meest waarschijnlijke tekst, in plaats van tekens te classificeren.
Dat verschil tussen voorspellen en classificeren klinkt academisch, maar het heeft één heel praktisch gevolg. Een classificerend systeem dat twijfelt, geeft een lage score af. Een voorspellend systeem dat twijfelt, geeft een vloeiend en plausibel antwoord af. Een bedrag dat er goed uitziet maar niet op de factuur staat, is niet te onderscheiden van een bedrag dat er wel staat.
De afweging: één laag of twee
| Alleen een AI-model | OCR plus een getraind model | |
| Afwijkende lay-outs | Sterk, gebruikt context en positie tegelijk | Sterk, mits het model op facturen is getraind |
| Herkomst van een waarde | Niet aanwijsbaar | Aanwijsbaar op het document |
| Twijfel zichtbaar maken | Nauwelijks | Per veld een betrouwbaarheidsscore |
| Reproduceerbaarheid | Kan per keer verschillen | Zelfde document, zelfde uitkomst |
| Verzonnen waarden | Mogelijk en moeilijk te zien | Zeer onwaarschijnlijk, de tekst komt uit de scan |
| Kosten bij volume | Hoger per document | Lager, OCR is goedkoop |
| Opzet | Weinig inrichting | Meer inrichting |
Voor een eenmalige vraag over één document wint de directe route. Voor duizenden facturen per maand die in een grootboek belanden en jaren later bij een controle moeten kloppen, wegen herkomst, reproduceerbaarheid en zichtbare twijfel zwaarder dan gemak bij de opzet.
Waarom TriFact365 twee lagen gebruikt
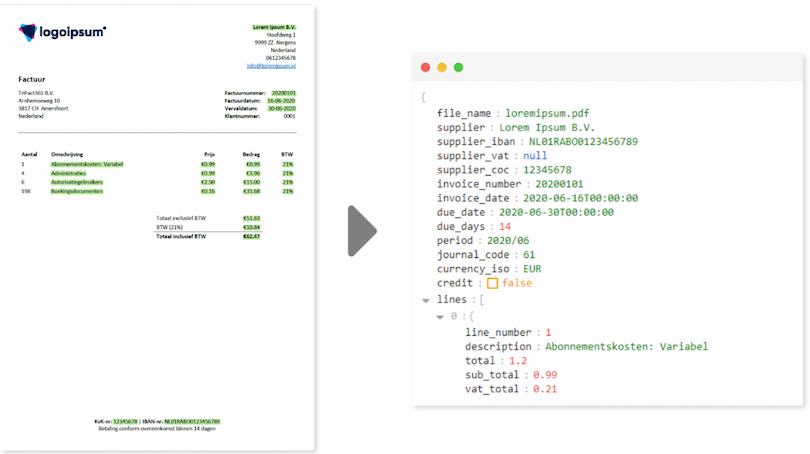
Bij TriFact365 bestaat OCR factuurherkenning uit twee lagen, en die volgorde is een bewuste keuze. De software combineert OCR met zelflerende AI. De eerste laag levert de harde tekst, verankerd aan een plek op het document en voorzien van een betrouwbaarheidsscore. De cijfers komen daarmee uit de factuur en niet uit een model dat tekst genereert. De tweede laag doet wat OCR niet kan: bepalen welk getal het totaal is, welke partij de leverancier is, en welke grootboekrekening en btw-code daarbij horen op basis van hoe deze leverancier eerder is geboekt, tot op regelniveau.
Wat de klant daarvan merkt, laat zich in vier punten samenvatten:
- Minder stille fouten. Een verkeerd bedrag valt op doordat de herkenning twijfel meldt, in plaats van dat het er overtuigend uitziet.
- Gerichter controleren. Documenten waarover de software zeker is, hoeven minder aandacht; de twijfelgevallen springen eruit.
- Aantoonbaar bij een controle. Het originele document staat naast het voorstel en je kunt aanwijzen waar een waarde vandaan komt.
- Beter per leverancier. Een correctie die je vandaag maakt, werkt door in de volgende factuur van diezelfde partij.
Het resultaat is een boekingsvoorstel in je eigen portal, met het document ernaast. Na jouw controle en verzending komt de boeking in je boekhoudpakket terecht. Hoe dat er in de praktijk uitziet, zie je bij scan en herken.
Drie hardnekkige misverstanden
- “OCR en factuurherkenning zijn hetzelfde.” OCR is de eerste stap. Factuurherkenning is OCR plus interpretatie plus codering. Aanbieders die alleen OCR leveren, verkopen je een doorzoekbare PDF.
- “Met e-facturen heb je geen OCR meer nodig.” Klopt voor het uitlezen: een UBL-factuur levert de gegevens al gestructureerd aan. Maar welke grootboekrekening en btw-code erbij horen staat er niet in, dus de tweede laag blijft nodig.
- “AI heeft OCR overbodig gemaakt.” Bij een losse vraag over één document vaak wel. In een administratie waar herkomst, herhaalbaarheid en controleerbaarheid tellen, is de combinatie sterker dan één van beide.
Veelgestelde vragen over OCR factuurherkenning
OCR factuurherkenning is het automatisch uitlezen van facturen met optische tekenherkenning, waarna een tweede laag bepaalt welk getal het totaal is, wie de leverancier is en welke boeking erbij hoort.
OCR staat voor Optical Character Recognition, oftewel optische tekenherkenning. Het is de techniek die tekens in een afbeelding herkent en omzet in digitale tekst met posities en betrouwbaarheidsscores.
OCR leest de tekst van een document uit. Factuurherkenning gaat verder en koppelt die tekst aan velden als leverancier, bedrag en btw, en stelt een grootboekrekening voor. OCR is dus onderdeel van factuurherkenning, niet hetzelfde.
Technisch kan dat: multimodale modellen lezen een afbeelding rechtstreeks. Het nadeel is dat zo’n model tekst voorspelt in plaats van tekens classificeert, waardoor een plausibel maar onjuist bedrag niet opvalt en de herkomst niet aanwijsbaar is.
Dat hangt van de bouw af. Sommige oplossingen draaien eerst een klassieke OCR-stap en voeren de tekst aan het model; dan is OCR verstopt, niet weg. Andere verwerken de afbeelding rechtstreeks, zonder aparte tekenherkenning met betrouwbaarheidsscores.
OCR verwijdert de invoerstap. De gegevens staan direct beschikbaar, waardoor matching, goedkeuring en betaling kunnen doorlopen zonder dat iemand de factuur eerst overtypt.
Afbeeldingen en scans zoals PDF, JPG, PNG en TIFF, plus foto’s uit een mobiele app. UBL-bestanden hoeven niet door OCR, want die leveren de gegevens al gestructureerd aan.
Nee. Scannen maakt een afbeelding van een document. OCR zet die afbeelding om in doorzoekbare tekst. Scannen is de eerste stap, OCR de tweede.
Kassabonnen worden op thermisch papier gedrukt en dat vervaagt. Zonder contrast tussen tekst en achtergrond valt er niets te herkennen. Fotografeer de bon daarom bij ontvangst in plaats van bij de maandafsluiting.
Bij TriFact365 wordt ruim 90% van de facturen direct correct herkend, door de combinatie van OCR en zelflerende AI. De herkenning wordt bovendien nauwkeuriger met elke verwerkte factuur van dezelfde leverancier.
Tot slot
OCR factuurherkenning draait om één scheiding: lezen is iets anders dan begrijpen. OCR levert de tekens, betrouwbaar en aanwijsbaar; een getraind model maakt er een boeking van. De verleiding om die twee in één stap te proppen is groot, en voor een losse vraag werkt dat prima. Zodra het om duizenden facturen gaat die jaren later nog moeten kloppen, zijn herkomst en herhaalbaarheid geen luxe. Wil je zien wat dat in de praktijk scheelt? Start gratis en verwerk je eerste facturen.